Neural Blind Source Separation
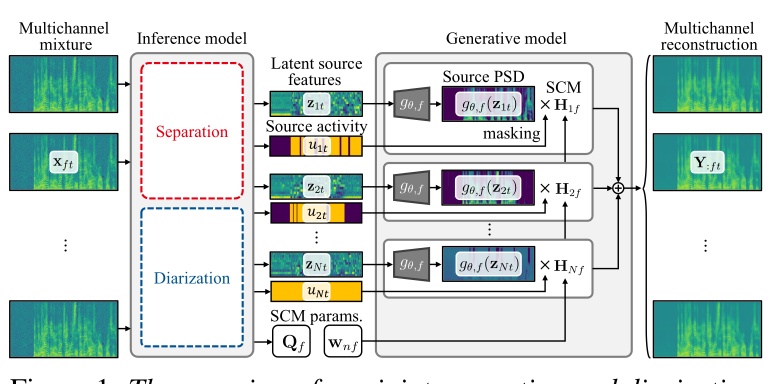
We study multichannel blind source separation using neural source models and neural inference, including empirical-Bayesian independent deeply learned matrix analysis (IDLMA), product-of-prior IDLMA (PoP-IDLMA), and independent deeply learned tensor analysis (IDLTA). This line also covers joint neural blind source separation and speaker diarization for distant multi-talker speech recognition.
Includes collaborative research on multi-talker speech recognition
Related Publications
- Yoshiaki Bando, Tomohiko Nakamura, Satoru Fukayama, and Shinji Watanabe, “Online frontend system for multi-talker DSR using neural blind source separation and diarization,” IEEE Transactions on Audio, Speech and Language Processing, vol. 34, pp. 3698–3713, July 2026.
- Yoshiaki Bando, Tomohiko Nakamura, and Shinji Watanabe, “Neural blind source separation and diarization for distant speech recognition,” in Proceedings of INTERSPEECH, Sept. 2024, pp. 722–726.
- Takuya Hasumi, Tomohiko Nakamura, Norihiro Takamune, Hiroshi Saruwatari, Daichi Kitamura, Yu Takahashi, and Kazunobu Kondo, “PoP-IDLMA: Product-of-prior independent deeply learned matrix analysis for multichannel music source separation,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 31, pp. 2680–2694, July 2023.
- Takuya Hasumi, Tomohiko Nakamura, Norihiro Takamune, Hiroshi Saruwatari, Daichi Kitamura, Yu Takahashi, and Kazunobu Kondo, “Multichannel audio source separation with independent deeply learned matrix analysis using product of source models,” in Proceedings of Asia Pacific Signal and Information Processing Association Annual Summit and Conference, Dec. 2021, pp. 1226–1233.
- Sota Misawa, Norihiro Takamune, Tomohiko Nakamura, Daichi Kitamura, Hiroshi Saruwatari, Masakazu Une, and Shoji Makino, “Speech enhancement by noise self-supervised rank-constrained spatial covariance matrix estimation via independent deeply learned matrix analysis,” in Proceedings of Asia Pacific Signal and Information Processing Association Annual Summit and Conference, Dec. 2021, pp. 578–584.
- Naoki Narisawa, Rintaro Ikeshita, Norihiro Takamune, Daichi Kitamura, Tomohiko Nakamura, Hiroshi Saruwatari, and Tomohiro Nakatani, “Independent deeply learned tensor analysis for determined audio source separation,” in Proceedings of European Signal Processing Conference, Aug. 2021, pp. 326–330.
- Takuya Hasumi, Tomohiko Nakamura, Norihiro Takamune, Hiroshi Saruwatari, Daichi Kitamura, Yu Takahashi, and Kazunobu Kondo, “Empirical bayesian independent deeply learned matrix analysis for multichannel audio source separation,” in Proceedings of European Signal Processing Conference, Aug. 2021, pp. 331–335.