Neural Analysis-by-Synthesis Based on DDSP Mixture Models
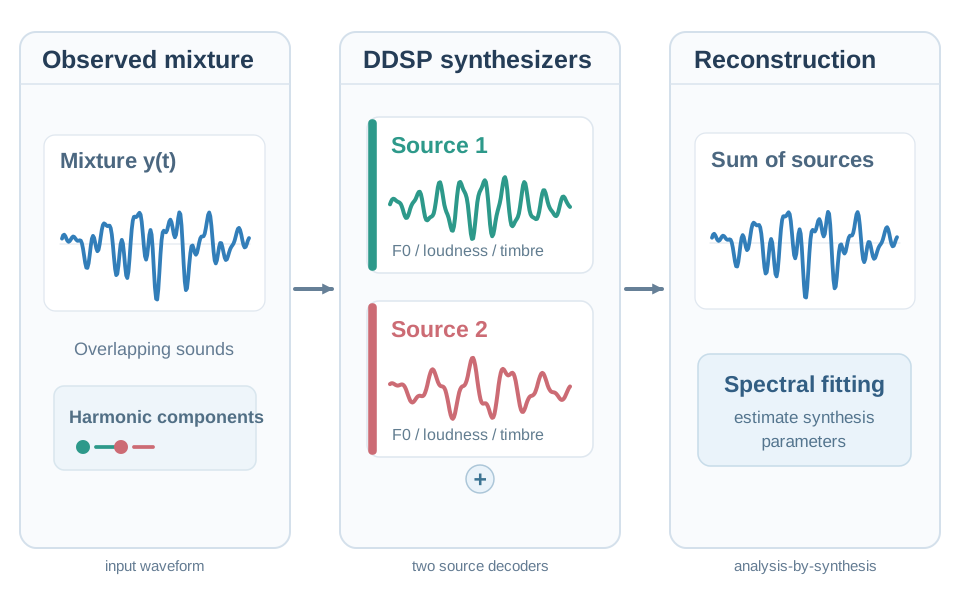
We develop analysis-by-synthesis methods for mixtures of harmonic sounds using differentiable digital signal processing (DDSP) mixture models. Neural inference estimates the synthesis parameters of constituent sounds from a mixture. Recent work incorporates diffusion-based estimation, and the same parameterized representation supports score-informed music-audio editing.
Related Publications
- Kengo Takemoto, Tomohiko Nakamura, and Hiroshi Saruwatari, “Differentiable digital signal processing mixture model-based diffusion for synthesis parameter estimation from harmonic sound mixtures,” in Proceedings of Asia Pacific Signal and Information Processing Association Annual Summit and Conference, Nov. 2026.
- Kengo Takemoto, Tomohiko Nakamura, and Hiroshi Saruwatari, “Diffusion-based music audio editing system using differentiable digital signal processing mixture model,” in Proceedings of International Conference on Digital Audio Effects, Demo Session, Sept. 2026.
- Kengo Takemoto, Tomohiko Nakamura, and Hiroshi Saruwatari, “Toward score-informed music audio editing system using differentiable digital signal processing mixture model,” in Late Breaking Session, International Society for Music Information Retrieval Conference, Sept. 2025.
- Masaya Kawamura, Tomohiko Nakamura, Daichi Kitamura, Hiroshi Saruwatari, Yu Takahashi, and Kazunobu Kondo, “Differentiable digital signal processing mixture model for synthesis parameter extraction from mixture of harmonic sounds,” in Proceedings of IEEE International Conference on Acoustics, Speech, and Signal Processing, May 2022, pp. 941–945.