音声表現学習と音声モデルの解析
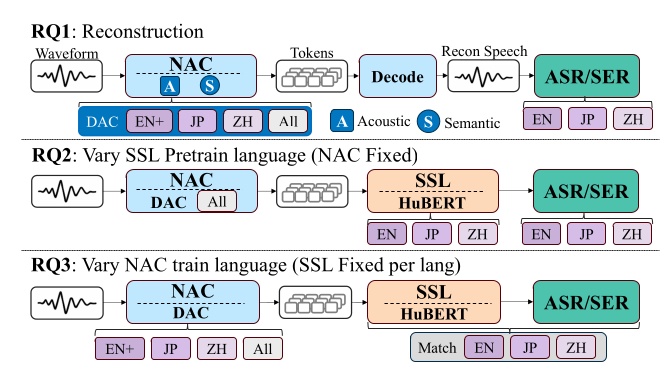
自己教師ありモデルや生成的音声言語モデルを含む,音声表現学習と効率的な音声モデリング・解析を研究しています.独立成分分析(ICA)による離散音声単位の抽出,音声表現に含まれる音韻・意味情報の比較,ニューラルオーディオコーデックのトークンを用いた事前学習言語への依存性の分析,生成的音声言語モデルによる雑音音声の表現分析などを扱います.別の研究課題として,SelfRemasterでは音源・フィルタ・収録チャネルをモデル化する自己教師あり分析合成により,歴史的音声資料などの劣化音声を,対となるクリーンな参照音声を用いずに復元します.
音声表現学習に関する研究の一部は,渡部晋治教授(CMU)との共同研究です.
関連文献
- Daigo Takizawa, Tomohiko Nakamura, Samuele Cornell, William Chen, Satoru Fukayama, and Shinji Watanabe, “Dissecting sensitivity to training language in self-supervised speech learning using neural audio codec tokens,” in Proceedings of INTERSPEECH, Sept. 2026, pp. 7274–7279.
- 瀧澤 大吾, 塩田 さやか, 中村 友彦, 須田 仁志, 深山 覚, “日本語音声SSLモデルの多面的評価に向けた下流タスク評価用データセット構成の検討,” 日本音響学会 2026年秋期研究発表会, Sept. 2026.
- 水野 友暁, 須田 仁志, 中村 友彦, 深山 覚, 中鹿 亘, “HuBERTトークンによる韻律抑制効果を用いた日本語アクセント変換の試み,” 電子情報通信学会技術研究報告, vol. 125, pp. 1–6, Mar. 2026.
- 瀧澤 大吾, 中村 友彦, Samuele Cornell, William Chen, 深山 覚, 渡部 晋治, “Neural audio Codecを用いた自己教師あり学習モデルにおける事前学習データの言語が下流タスクに与える影響の検証,” 日本音響学会 2026年春期研究発表会, Mar. 2026.
- 瀧澤 大吾, 中村 友彦, Samuele Cornell, William Chen, 深山 覚, 渡部 晋治, “Neural audio Codecを用いた低コストな自己教師あり学習モデルの検討,” 日本音響学会 2026年春期研究発表会, Mar. 2026.
- Tomohiko Nakamura, Kwanghee Choi, Keigo Hojo, Yoshiaki Bando, Satoru Fukayama, and Shinji Watanabe, “Discrete speech unit extraction via independent component analysis,” in Proceedings of SALMA: Speech and Audio Language Models - Architectures, Data Sources, and Training Paradigms, IEEE International Conference on Acoustics, Speech, and Signal Processing Workshops, Apr. 2025.
- 中村 友彦, チョイ クワンヒー, 北條 圭悟, 坂東 宜昭, 深山 覚, 渡部 晋治, “独立成分分析を利用した離散音声トークン抽出法,” 情報処理学会研究報告, vol. 2025–SLP–155, Mar. 2025.
- 瀧澤 大吾, 中村 友彦, 須田 仁志, 深山 覚, “大規模自己教師あり学習モデルによる日本語方言の音声認識,” 日本音響学会 2025年春期研究発表会, pp. 969–972, Mar. 2025.
- Kwanghee Choi, Ankita Pasad, Tomohiko Nakamura, Satoru Fukayama, Karen Livescu, and Shinji Watanabe, “Self-supervised speech representations are more phonetic than semantic,” in Proceedings of INTERSPEECH, Sept. 2024, pp. 4578–4582.
- Takaaki Saeki, Shinnosuke Takamichi, Tomohiko Nakamura, Naoko Tanji, and Hiroshi Saruwatari, “SelfRemaster: Self-supervised speech restoration for historical audio resources,” IEEE Access, vol. 11, pp. 144831–144843, Jan. 2024.
- Joonyong Park, Shinnosuke Takamichi, Tomohiko Nakamura, Kentaro Seki, Detai Xin, and Hiroshi Saruwatari, “How generative spoken language model encodes noisy speech: Investigation from phonetics to syntactics,” in Proceedings of INTERSPEECH, Aug. 2023, pp. 1085–1089.
- 朴 浚鎔, 高道 慎之介, 中村 友彦, 関 健太郎, 辛 徳泰, 猿渡 洋, “Generative spoken language Modelを用いた劣化雑音音声の分析と他言語への適用,” 日本音響学会 2023年春期研究発表会, pp. 677–680, Mar. 2023.
- Takaaki Saeki, Shinnosuke Takamichi, Tomohiko Nakamura, Naoko Tanji, and Hiroshi Saruwatari, “SelfRemaster: Self-supervised speech restoration with analysis-by-synthesis approach using channel modeling,” in Proceedings of INTERSPEECH, Sept. 2022, pp. 4406–4410.
- 佐伯 高明, 高道 慎之介, 中村 友彦, 丹治 尚子, 猿渡 洋, “ソース・フィルタ・チャネル分解に基づく自己教師ありニューラル音声復元,” 情報処理学会研究報告, vol. 2022–SLP–140, no. 41, Mar. 2022.